为什么企业 NL2SQL 容易翻车
真正让自然语言问数在生产环境落不了地的,通常不是大模型不会写 JOIN,而是以下三类现实问题:
- 表字段含义与真实业务口径脱节:表里明明叫
order_amount,但实际核算 GMV 必须排除is_test = 1的内部测试单和status IN ('cancelled', 'refunded')的退款单——模型单看 DDL 根本猜不到。 - 安全与性能失控:直接连主库、没有只读约束、没有屏蔽
phone/id_card等隐私字段,或写出无LIMIT的全表扫描拖慢线上交易。 - 表结构迭代导致知识失同步:研发加了新枚举值或新字段,手工整理的提示词迅速过时;如果重新全量导入又会把辛苦写好的业务注释全部覆盖掉。
实施四步走:从只读从库到可视化经营问数
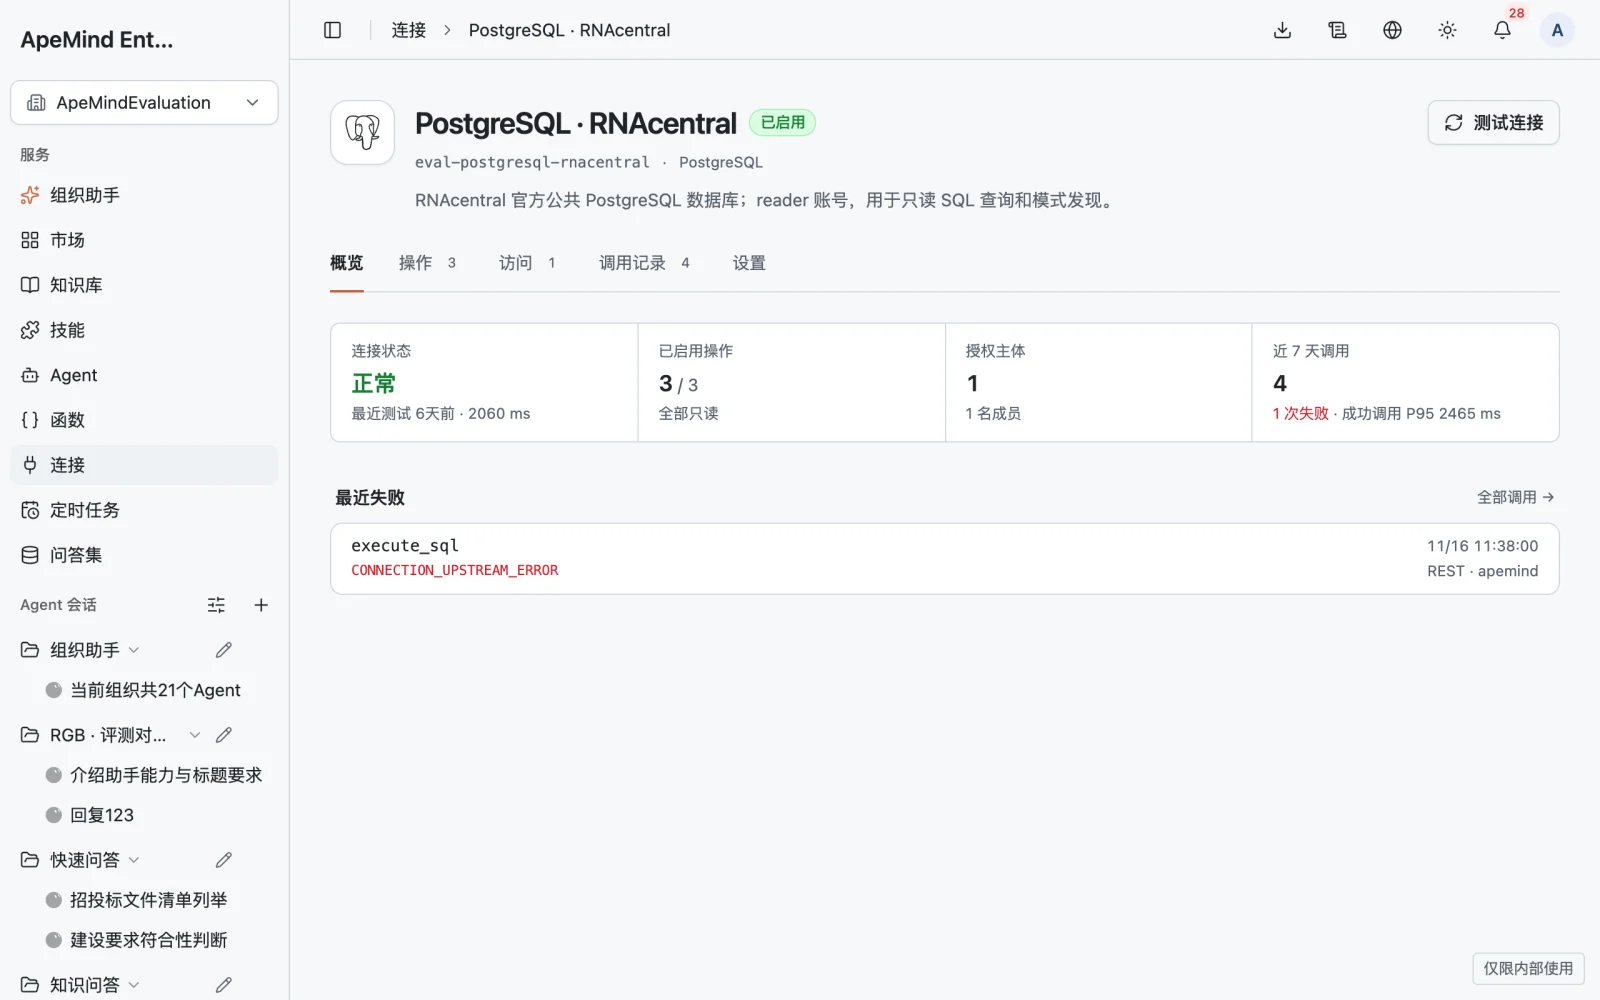
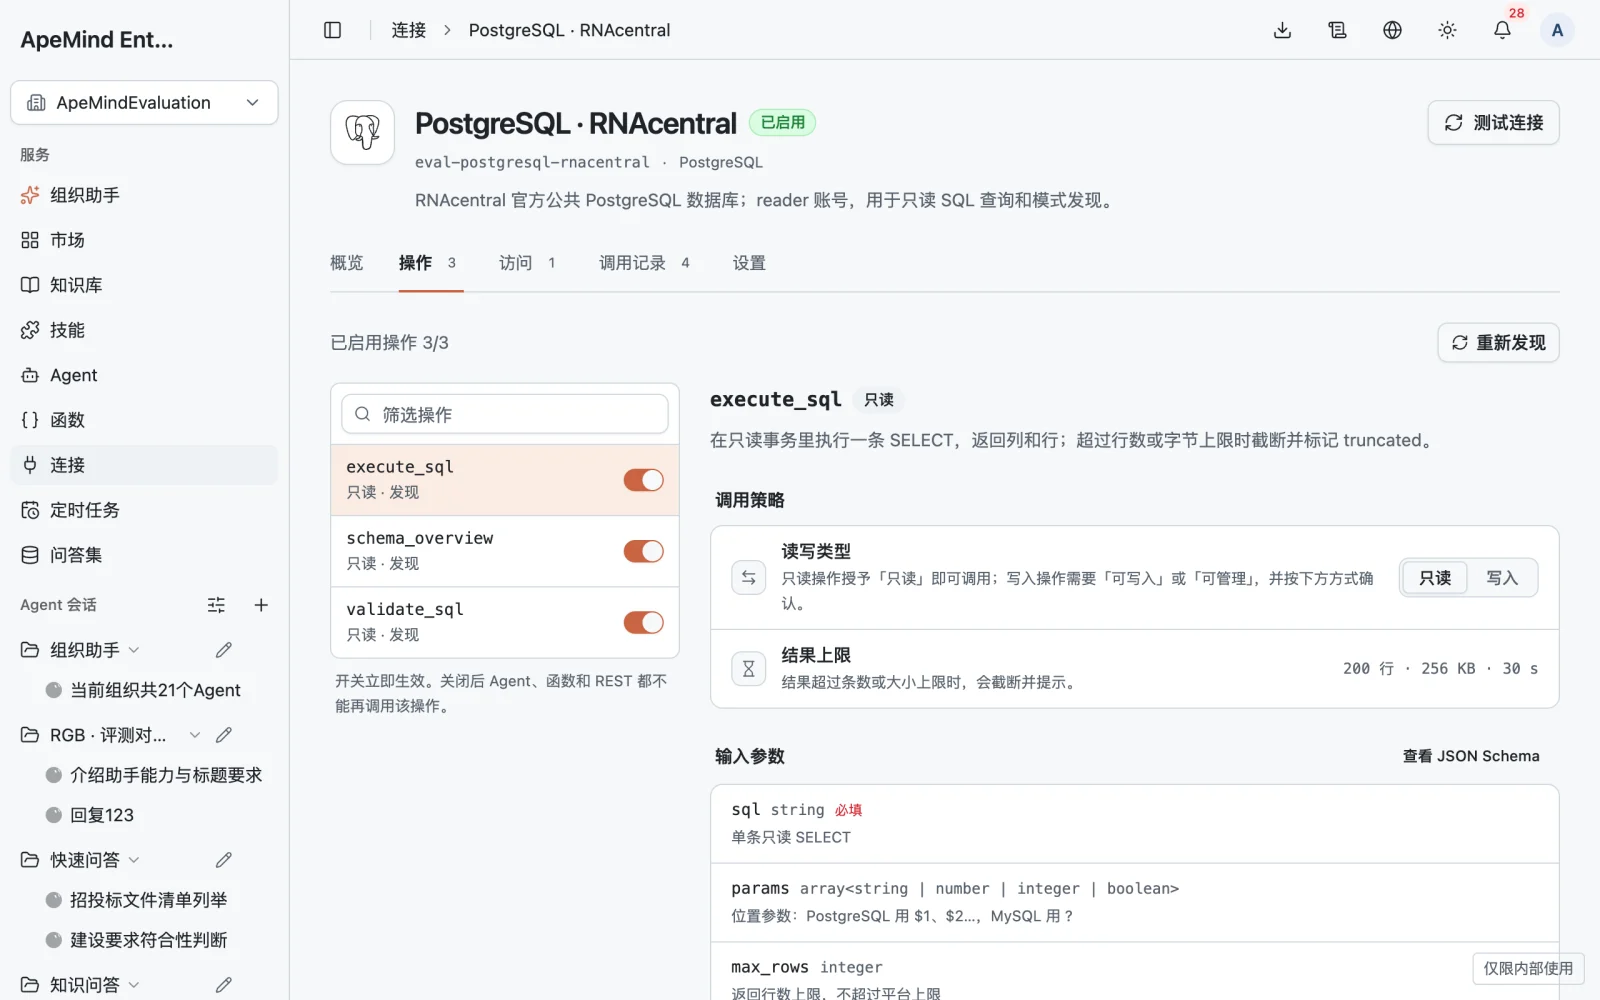
第一步:用独立只读账号登记数据库连接并启用受管操作
由 DBA 在业务分析从库(PostgreSQL / MySQL Read Replica)上创建一个仅授予分析视图/白名单表 SELECT 权限的独立账号,并在 ApeMind「连接」中登记为受管连接(详见数据库知识库与自然语言问数):
- 仅启用
schema_overview、validate_sql和只读execute_sql三个受管操作,底层禁止一切 DDL/DML 写入; - 连接可见性设为仅指定成员,凭据只写不读,终端业务用户永远拿不到数据库密码,也无法绕过 Agent 直连数据库。
第二步:创建数据库知识库,自动发现 Schema 并沉淀业务口径
新建数据库类型知识库并绑定上述只读连接,一键触发 Schema 发现。在预览清单中只勾选业务分析所需的订单、商品、渠道与区域维表,直接排除含个人隐私或财务底稿的敏感表,并对必要展示表中的手机号、姓名等列勾选脱敏/屏蔽。
由数据分析师在关键表和核心字段旁补写业务语义注释与枚举字典——这一步直接决定问数准确率:
orders.pay_amount:“实付金额,单位为分,展示时须除以 100 转换为元”;orders.status:“paid=已支付、shipped=已发货、refunded=已全额退款;核算有效 GMV 时必须加条件is_test = 0 AND status NOT IN ('cancelled', 'refunded')”;- 常用关联路径:标明“订单表通过
channel_id关联渠道维表dim_channels.id,按大区聚合时关联dim_regions”。
把公司现有的《经营指标字典.pdf》放到普通文档知识库中,稍后一起挂给问数 Agent,让“指标定义文档 + 实时数据库 Schema”双剑合璧。
第三步:配置「问数 + 可视化」Agent 与权限隔离
新建「经营问数助手」Agent,按部门权限做清晰边界控制:
- 绑定资源:同时绑定「经营分析数据库知识库」(只读)、「指标字典文档库」(只读)以及只读数据库连接;如果不同大区经理只能看各自区域数据,可为各区域分别配置基于只读视图的连接与独立 Agent,实现天然数据隔离。
- 开启代码模式 + 图解表达技能:开启代码模式并装载内置的「图解表达」「表格文件」技能。这样 Agent 执行完 SQL 拿到汇总数据后,能立即用 Python 做环比/同比二阶计算、画趋势折线图与漏斗图,并导出带数据的 Excel 表格。
- 写清问数与透明核验指令:
- “生成 SQL 前必须先核对数据库知识库中的字段注释与有效订单过滤条件,禁止自行猜测字段含义或单位。”
- “每次查询必须加明确时间范围与行数上限;输出经营结论时,默认附带实际执行的 SQL 语句、统计口径说明(如是否排除测试单与退款)以及时间区间,方便业务方随时复核。”
第四步:应对表结构变更——三方合并 Diff 审核与一键回滚
当业务研发给 orders 表新增了 coupon_discount 字段或修改了枚举值后,管理员只需回到数据库知识库再次点击同步 Schema:
- 系统以三方合并 Diff 视图清晰高亮新增/变更列,同时完整保留此前手工填写的所有业务口径注释,绝不暴力覆盖;
- 数据分析师在 Diff 页面顺手为新字段补一句注释并确认发布,即刻生成新的 Schema 版本;如发现新口径影响线上报表,随时可一键回滚至上一稳定版本。
把高频经营看板沉淀为「函数 + 定时任务」:对于全员每天都要看的《昨日核心经营日报》,可以把已经验证无误的 SQL 封装为只读函数确保 100% 稳定口径,再配一条每日 08:30 的定时任务自动生成日报并汇总异常波动。
验收与治理清单
| 检查维度 | 上线前验收要点 |
|---|---|
| 安全隔离 | 确认连接使用独立分析从库只读账号,测试尝试执行 UPDATE/DELETE 被底层直接拒绝;隐私字段已从 Schema 清单屏蔽。 |
| 口径一致 | 用 20 道历史真实取数需求建立问答集,对比 Agent 计算结果与 BI 看板口径误差为 0。 |
| 可审计透明 | 每次回答均展示执行 SQL、过滤口径与数据时间范围,业务负责人可一键复核或转发给分析师抽检。 |