为什么纯 NL2SQL 在企业里容易翻车
把表结构直接丢给模型生成 SQL,在真实业务库里通常会立刻遇到三个问题:
- 业务口径不在建表语句里:
status = 3代表“已签收”还是“已退款”?“净营收”要不要扣减优惠券与测试账号订单?数据库 DDL 里根本没写。 - 表结构随版本迭代漂移:研发加字段、拆表后,手写的指标文档迅速过期;重新扫描又容易把业务同学辛苦补充的注释全部覆盖掉。
- 安全与性能风险:直接给模型高权限账号或放任不带
LIMIT的全表扫描,会威胁生产库安全,也可能把包含 PII 的敏感列暴露给无关人员。
ApeMind 提供两条互补的落地路径,可单独使用也可组合配合:
- 数据库受管连接(立即可用):在组织连接中登记 PostgreSQL / MySQL 只读账号,通过服务端只读校验与截断保护,让 Agent 直接查表结构并执行只读 SQL。
- 数据库知识库(Schema 资产与口径治理):自动扫描勾选表的 Schema 生成结构化知识资产,将「机器自动生成区」与「人工业务口径区」解耦,并支持结构变更 Diff 审阅与版本回滚。
第一步:建立只读数据库连接
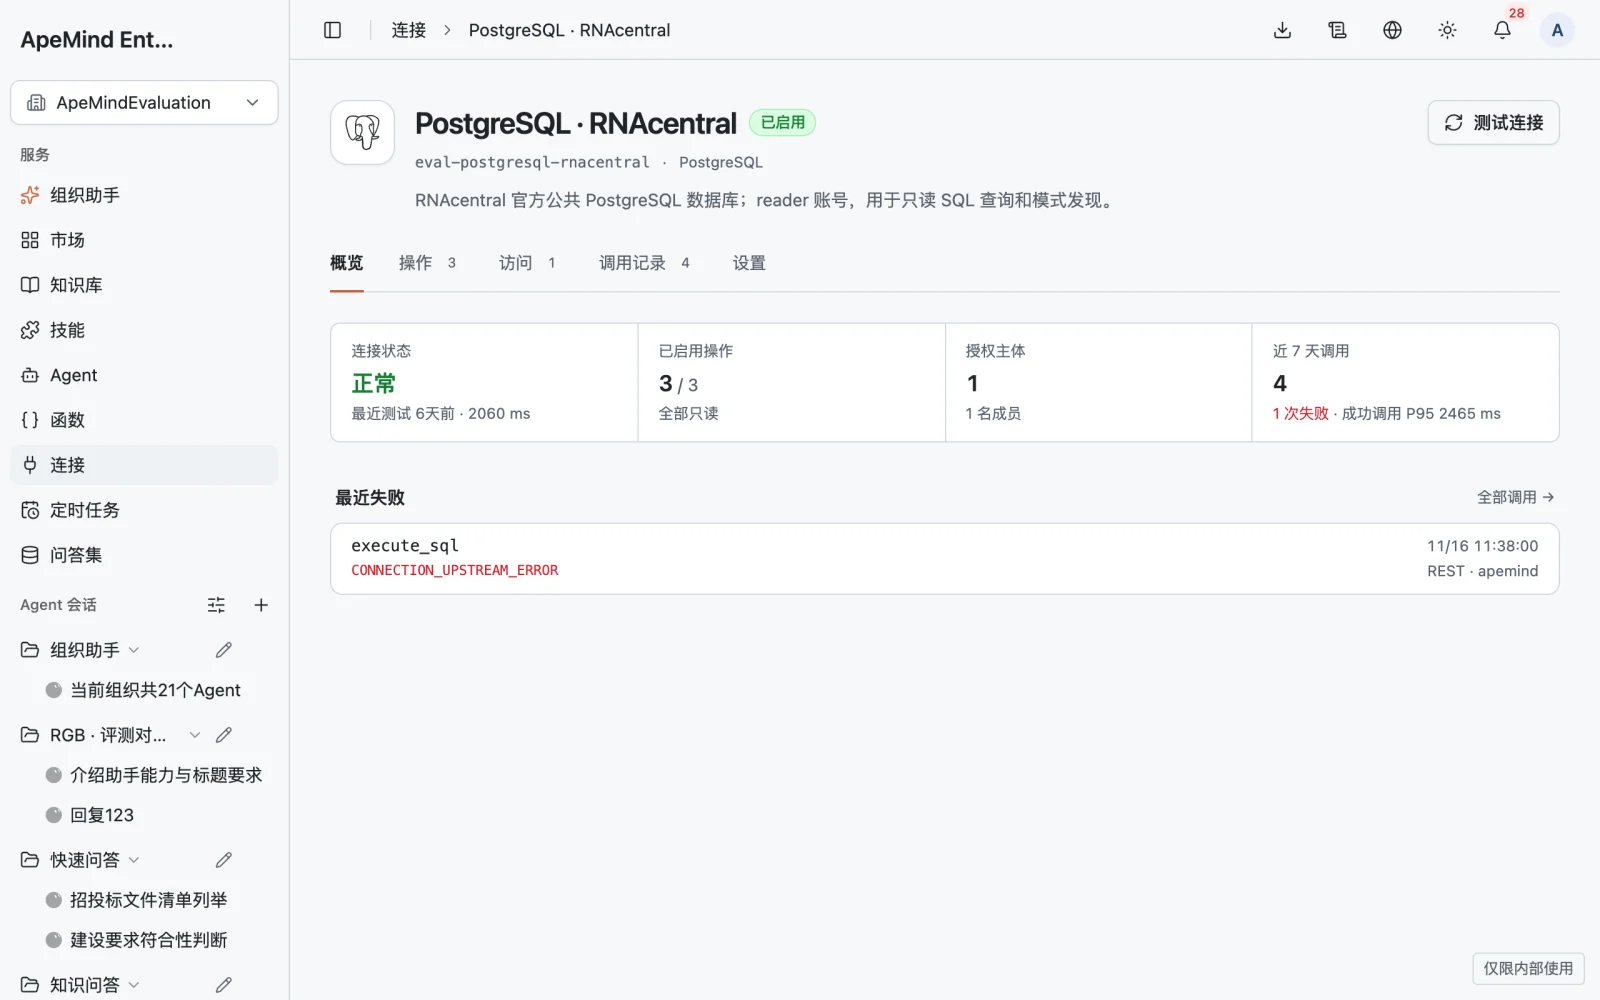
无论是否进一步生成数据库知识库,第一步都是在组织连接中以只读副本账号接入数据库,确保凭据与安全边界统一受管:
在业务数据库的只读副本(Read Replica)上创建专用账号,仅授予目标 Schema 和表的 SELECT 权限,绝不要在生产主库上使用写权限账号。
进入左侧栏连接 → 添加连接,选择 PostgreSQL 或 MySQL,填写主机、端口、数据库名与只读账号密码,点击测试连接验证连通性。密码只写不读,保存后永不回显。
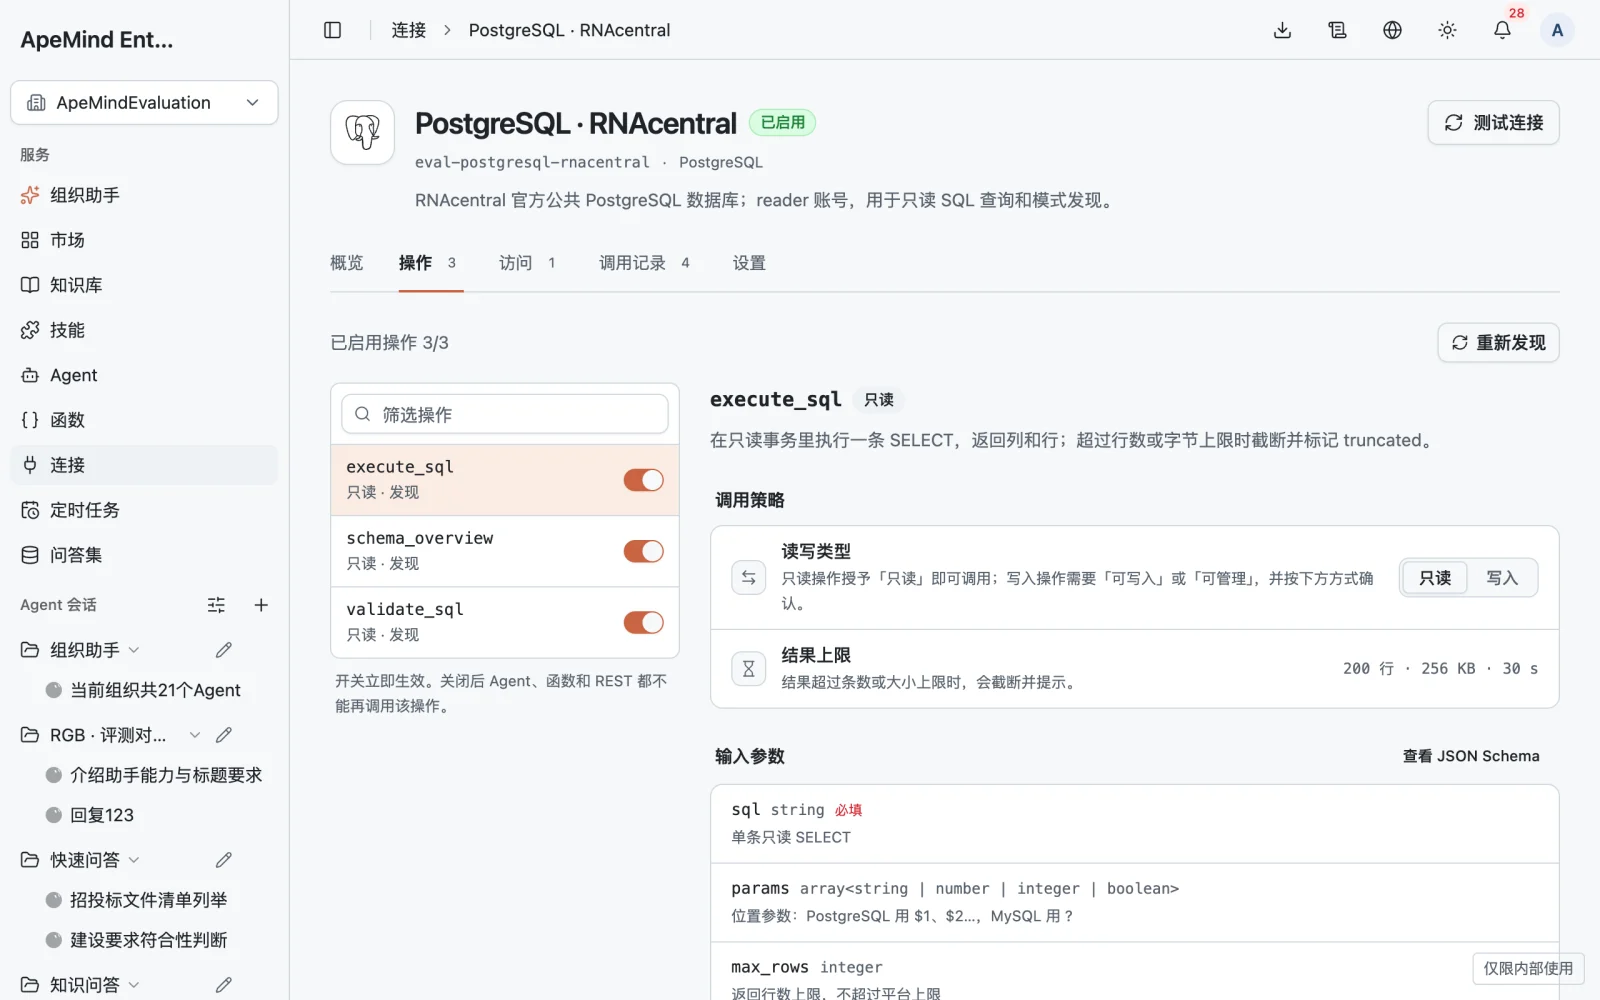
测试通过后,进入该连接的操作页签,按需启用 schema_overview(探查表结构与字段)、validate_sql(只读语法校验)与 execute_sql(执行只读 SQL)。服务端会在执行前强制校验 SQL 为只读,并按行数与字节数上限截断结果。
第二步:Schema 发现与业务口径沉淀
如果所在部署已启用数据库知识库,在知识库列表点击新建数据库知识库,即可把分散的表结构与团队业务口径沉淀为可检索、可维护的知识文档集(未启用独立向导的部署,也可以直接将口径手册作为 Markdown 放进文档知识库,并与上一步的数据库连接一起绑定给同一个 Agent):
- 基本信息与连接测试:为数据库知识库命名、选择数据库引擎,填写只读连接信息并完成连接测试。
- 敏感列屏蔽与采样控制:数据采样默认关闭;若确认合规并开启少量真实行采样以提升字段摘要质量,可把身份证号、手机号、邮箱等列按
schema.table.column格式填入敏感列清单,确保其绝不参与采样与摘要。 - 选择纳管的业务表:默认全部不选,仅勾选需要面向业务开放的核心宽表与维表(建议屏蔽底层框架表、临时表与审计日志表),提交后系统自动扫描表结构、主键、外键、索引与注释,生成结构化的表说明文档。
- 补充人工业务口径与示例 SQL:在生成的表文档中,于人工注释区写明关键指标定义(例如“有效 GMV 剔除
order_status IN ('cancelled','refunded')且排除is_test = true”)、枚举值含义以及常用多表 JOIN 示例查询。
把高频指标口径(如“复购率”“净毛利”“活跃客户”)和 5–10 条标准示例 SQL 写进知识库文档,往往比更换更贵的模型带来更明显的问数准确率提升。
第三步:结构变更 Diff 审阅与版本回滚
业务迭代新增字段或调整表结构后,进入数据库知识库的数据库维护页签即可无痛同步,而不丢失人工沉淀:
- 重新发现结构:点击「重新发现结构」,系统扫描最新数据库目录,自动计算「新增表」「删除表」「结构变更(字段/键/索引/注释)」差异,状态进入待审阅。
- 三方合并,保护人工注释:审阅差异并点击应用变更后,系统只重写机器区;你在文档里手写的业务口径与示例查询完整保留,已被数据库删除字段的原注释则自动归档到变更史备查。
- 一键版本回滚:每次生成与变更应用都会记录版本号(如
v1、v2)。如需撤销某次表范围或结构更新,在版本历史中选择目标版本点击「回滚到此版本」,系统会生成一个新的恢复版本,完整保留变更史。
第四步:配置问数 Agent 与权限边界
把准备好的数据库连接与口径知识库交给专门的问数 Agent:
- 在 Agent 配置页的资源权限中,绑定包含业务口径的知识库,并授予对应数据库连接的使用(只读)权限。
- 在人设与指令中明确要求:先查业务口径知识库再写 SQL;回答时同时展示口径说明、执行的 SQL 语句与结果摘要;遇到未在口径文档中定义的指标先向用户确认,不要自行臆测。
- 如需在查询后做环比/同比计算、异常归因或生成图表文件,可以同时为该 Agent 开启代码模式(Code Mode)。
权限按组织角色与连接授权严格隔离:财务分析 Agent 只绑定财务只读副本连接,销售分析 Agent 只绑定销售只读库,成员在对话中绝不会越权查询未授权的数据库。