数据源同步适用于组织知识库,且操作人需要具备该知识库的维护权限。其中飞书和邮箱数据源复用组织内已配置的连接,凭据集中托管、无需重复填写。
支持的三种数据源
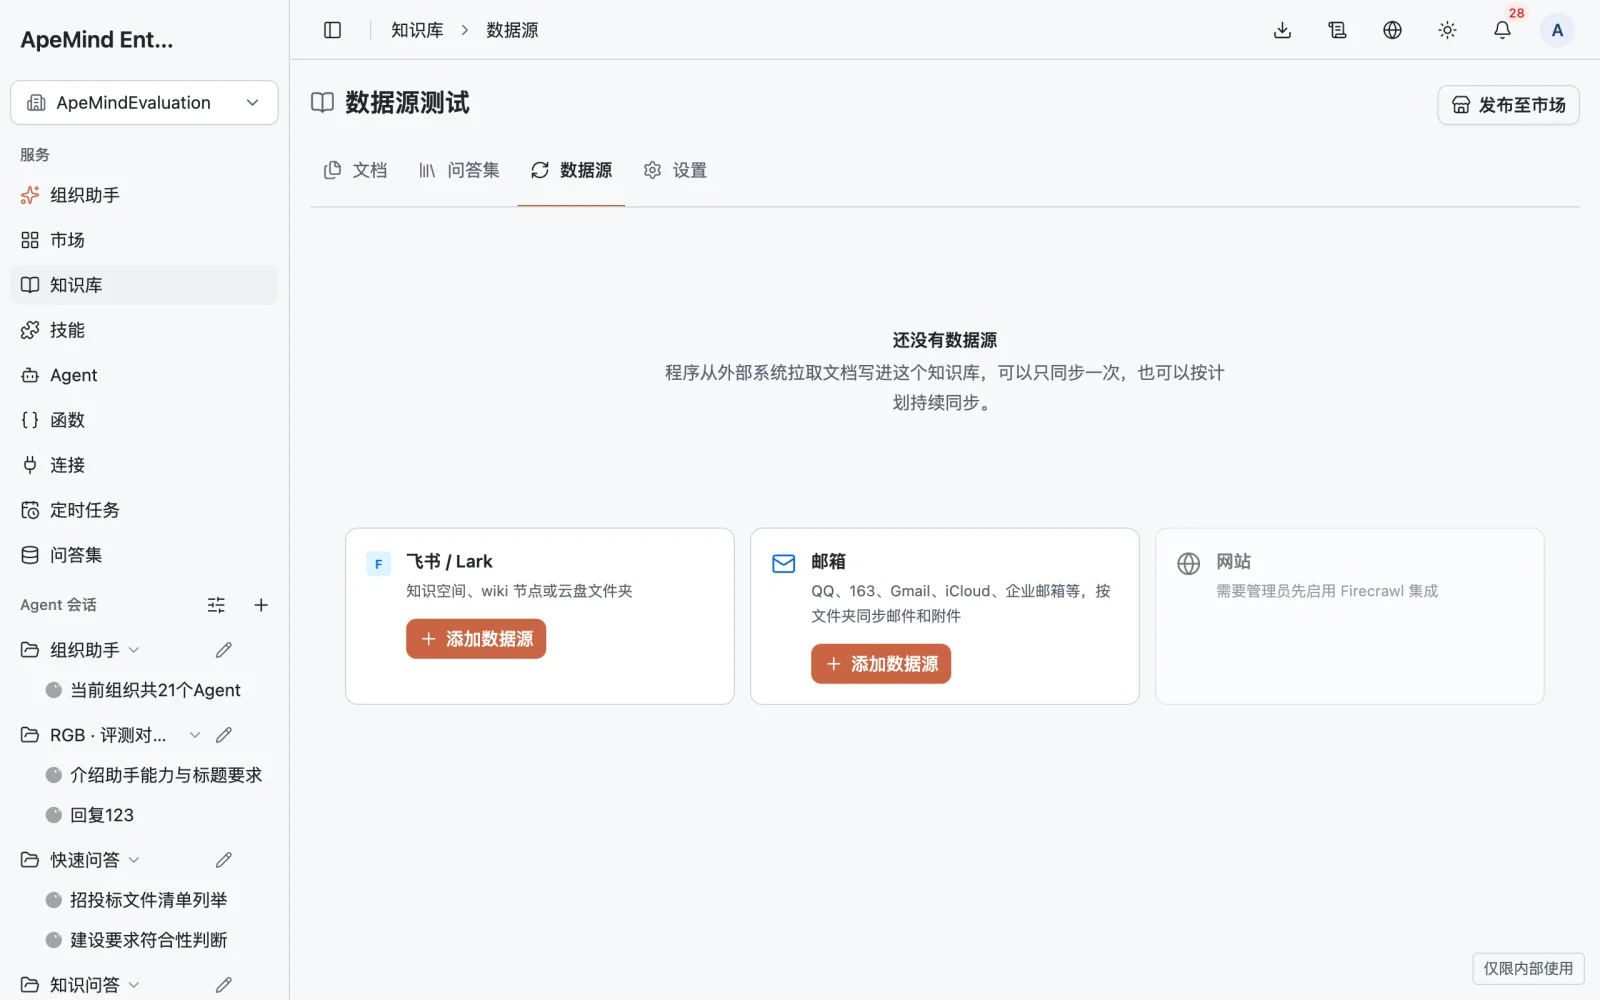
打开目标知识库,切换到顶部的数据源页签,点击添加数据源即可看到当前可用的同步类型:
| 数据源类型 | 同步内容 | 前置条件 |
|---|---|---|
| 飞书 / Lark | 飞书知识空间、指定 Wiki 节点树,以及云盘文件夹下的文档与附件 | 在组织「连接」中添加飞书自建应用连接,并将知识空间或文件夹分享给该应用 |
| 网站 | 整站抓取同域名页面,或持续盯紧指定的多个公开网页 URL | 平台管理员已启用网页抓取(Firecrawl)集成 |
| 邮箱(IMAP) | QQ、163、Gmail、iCloud 或企业邮箱指定文件夹内的邮件正文及附件(严格只读,不标已读、不移动、不删除) | 在组织「连接」中添加邮箱 IMAP 连接(邮箱地址 + 授权码) |
按类型配置同步范围
选择一个状态正常的飞书连接;若尚未建立,可直接在向导中跳转到连接页面用飞书扫码快速创建。
界面会列出已分享给该飞书应用的知识空间,勾选父节点即自动包含其全部子文档。如需同步云盘文件夹或指定节点,直接将飞书链接粘贴到输入框并按回车添加。
如果列表为空,请在飞书知识库的「知识空间设置 → 成员设置」中把包含应用机器人的群(或应用本身)加入成员;若缺少 API 权限,界面会直接列出缺失的权限项与快捷跳转入口。
- 整站抓取:填写入口网址(例如
https://docs.example.com)并设置最多页数上限,系统自动发现并抓取同一域名下的页面。 - 单个网页:只抓取精确列出的网页地址,可一次添加多个页面,适合跟踪定价页、公告栏或单篇法规页。
- 页数上限保护:如果整站抓取触及最大页数上限,系统会将本次同步标记为「不完整」,不会把未抓到的页面误标为「源端已删除」。
- 按邮箱文件夹勾选需要同步的目录(例如「收件箱」「客户工单」「项目周报」),支持同时提取邮件正文与受支持的文档附件。
- 系统自动跳过垃圾邮件、已删除邮件与草稿箱,避免噪声污染知识库。
- 同步过程严格只读,绝不会修改邮件的已读/未读状态,也不会移动或删除源邮箱里的任何邮件。
同步计划与增量更新机制
选定范围后,在同步计划中选择执行频次:
- 不自动:添加数据源后仅执行首次全量同步;后续有需要时随时回到页面点击立即同步。
- 每天 / 每周 / 每月:指定具体星期、日期与执行时间,系统按计划自动拉取变更,无需人工值守。
每次同步都会比对源端版本与内容摘要,只重新解析并索引真正发生新增或修改的文档,未变化的文档直接跳过,大幅节省模型与计算开销。当源端文档发生微调时,解析后的增量复用机制还会继续复用未改动片段的向量与图谱,详见版本化入库与增量复用。
处理「源端已删除」的文档
当一篇文档在飞书被移出知识空间、在网站被下线,或你缩小了数据源同步范围时,ApeMind 不会直接静默删掉知识库里的已有文档,防止误配置导致重要资料意外消失:
- 下一次完整同步结束后,这些源端已不存在的文档会被标记为源端已删除。
- 在数据源详情页下方可以查看被标记的文档清单,确认无误后一键批量清理。
- 如果直接移除整个数据源,已经导入知识库的文档默认保留,你可以在文档列表按需决定去留。
查看同步记录与故障排查
进入具体数据源的详情页,可以查看历次同步的触发方式(添加时 / 手动 / 定时)、状态(成功 / 部分完成 / 失败)、成功文档数与失败明细:
| 常见异常 | 原因 | 处理方法 |
|---|---|---|
| 状态显示「连接失效」 | 上游连接被停用、OAuth 令牌过期或邮箱授权码变更 | 点击页面中的「去修复连接」,在连接详情页更新凭据并测试通过后,再点「立即同步」。 |
| 单次同步显示「部分完成」 | 少数源文档无读取权限、格式损坏或超过单文件大小上限 | 展开本次运行记录的失败列表查看具体文档与原因;其余正常文档均已生效,不影响使用。 |
| 飞书同步看不到新加的文档 | 新文档所在目录未分享给飞书应用,或飞书应用发布版本未生效 | 在飞书确认目录权限已覆盖该应用,点击「刷新」重新拉取目录树后发起同步。 |