场景挑战与核心思路
券商投研、企业战略投资与财务分析团队在做行业竞品对标时,通常要同时翻阅 5–10 份几百页的 PDF 年报和券商深度研报。传统 RAG 方案在这个场景下会踩三个坑:
- 复杂报表解析错行:合并表头、多栏排版或跨页利润表解析成乱序纯文本,导致“营业成本”和“营业收入”张冠李戴。
- 大模型口算不可信:让大模型直接心算同比增长率、三年复合增长率(CAGR)或统一“元 / 万元 / 亿元”量纲,极易出现细微小数偏差,无法直接放进投委汇报材料。
- 审计溯源耗时:报告里引用的每一个关键指标,审稿人都要求能秒级翻回原始 PDF 页码核对口径与附注说明。
ApeMind 解法:用版面感知 PDF 解析保真还原表格与页码坐标 → 开启 Agent 代码模式(Code Mode)在隔离沙箱里用 Python 完成清洗、量纲统一、比率计算与图表绘制 → 通过句级引用与原文溯源抽屉逐笔核验原始披露数据。
实施步骤
第一步:建库并验证复杂 PDF 表格解析质量
新建「新能源行业年报与研报库」,把目标企业近三年年报 PDF(如《比亚迪 2025 年年度报告.pdf》等)及关键行业研报批量上传入库,同时开启知识图谱以串联控股子公司、上下游供应商与核心产品线关系。
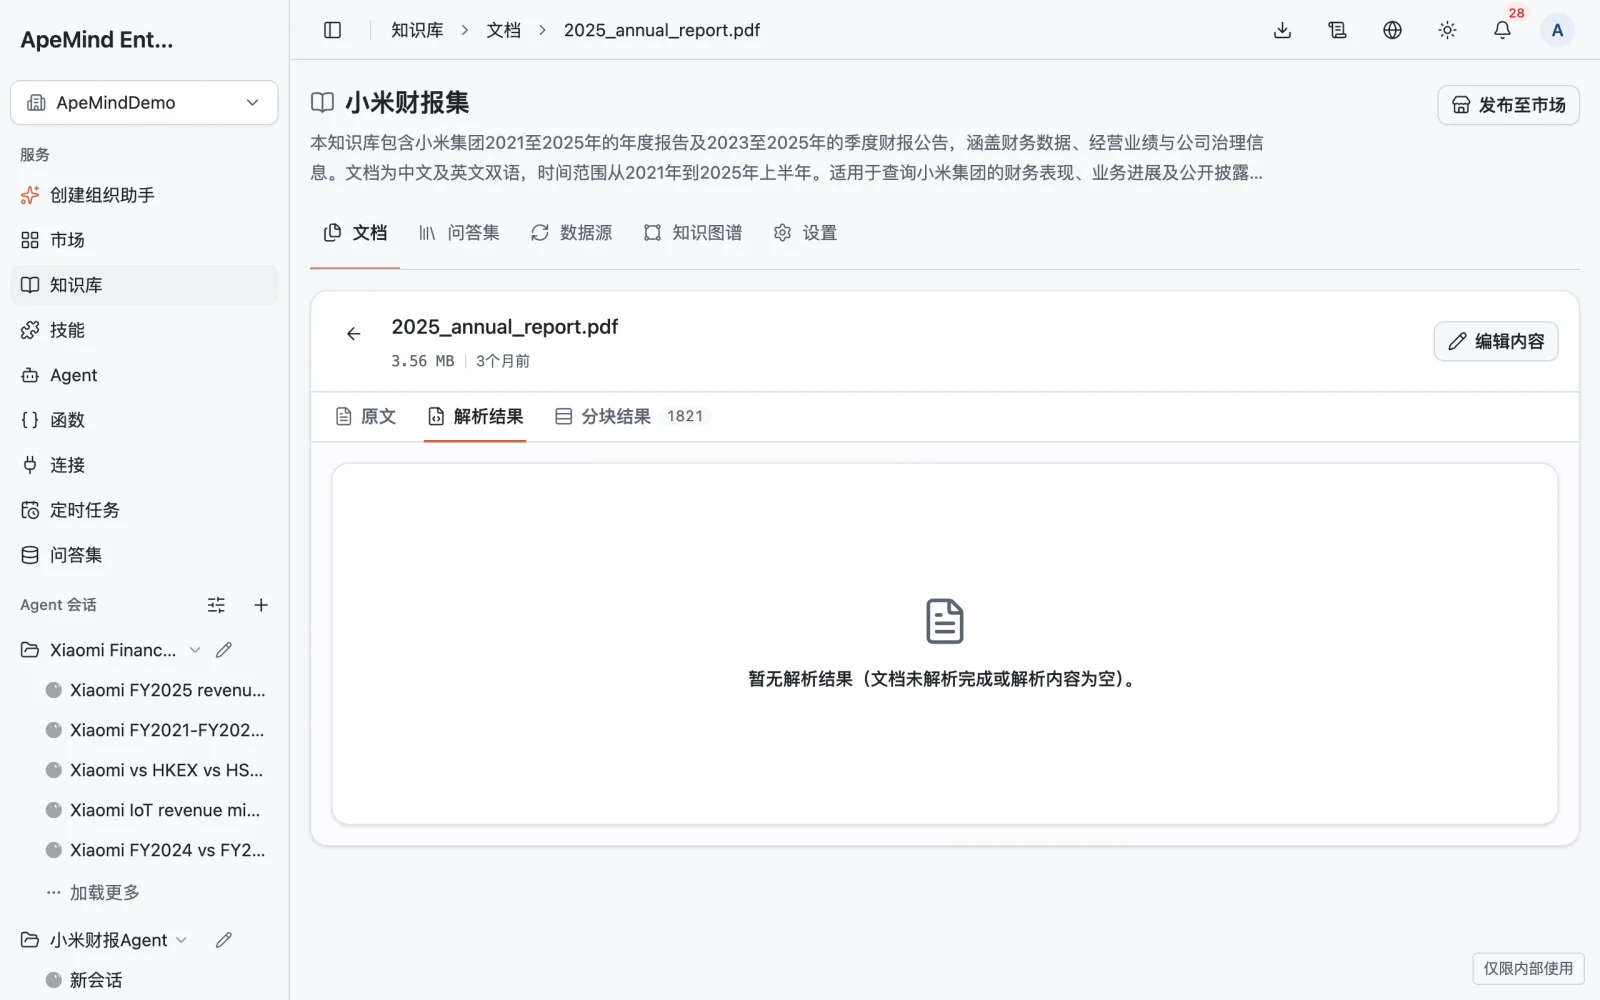
入库完成后,点开一份典型年报,在详情页对照查看原文、解析结果和分块结果,确认「合并利润表」「合并资产负债表」「分业务营收构成」的行列结构与货币单位(如“单位:千元”或“单位:元”)准确无误。
投研分析高度依赖核对 PDF 原页页码。如个别长附注切分不够理想,优先在知识库设置中开启用决策模型自动切分,而不要手工编辑 PDF 正文,从而完整保留原始 PDF 页码定位信息。
第二步:配置「代码模式 + 报告技能」投研分析 Agent
新建「财报深度分析助手」Agent,在配置页完成三项关键设置:
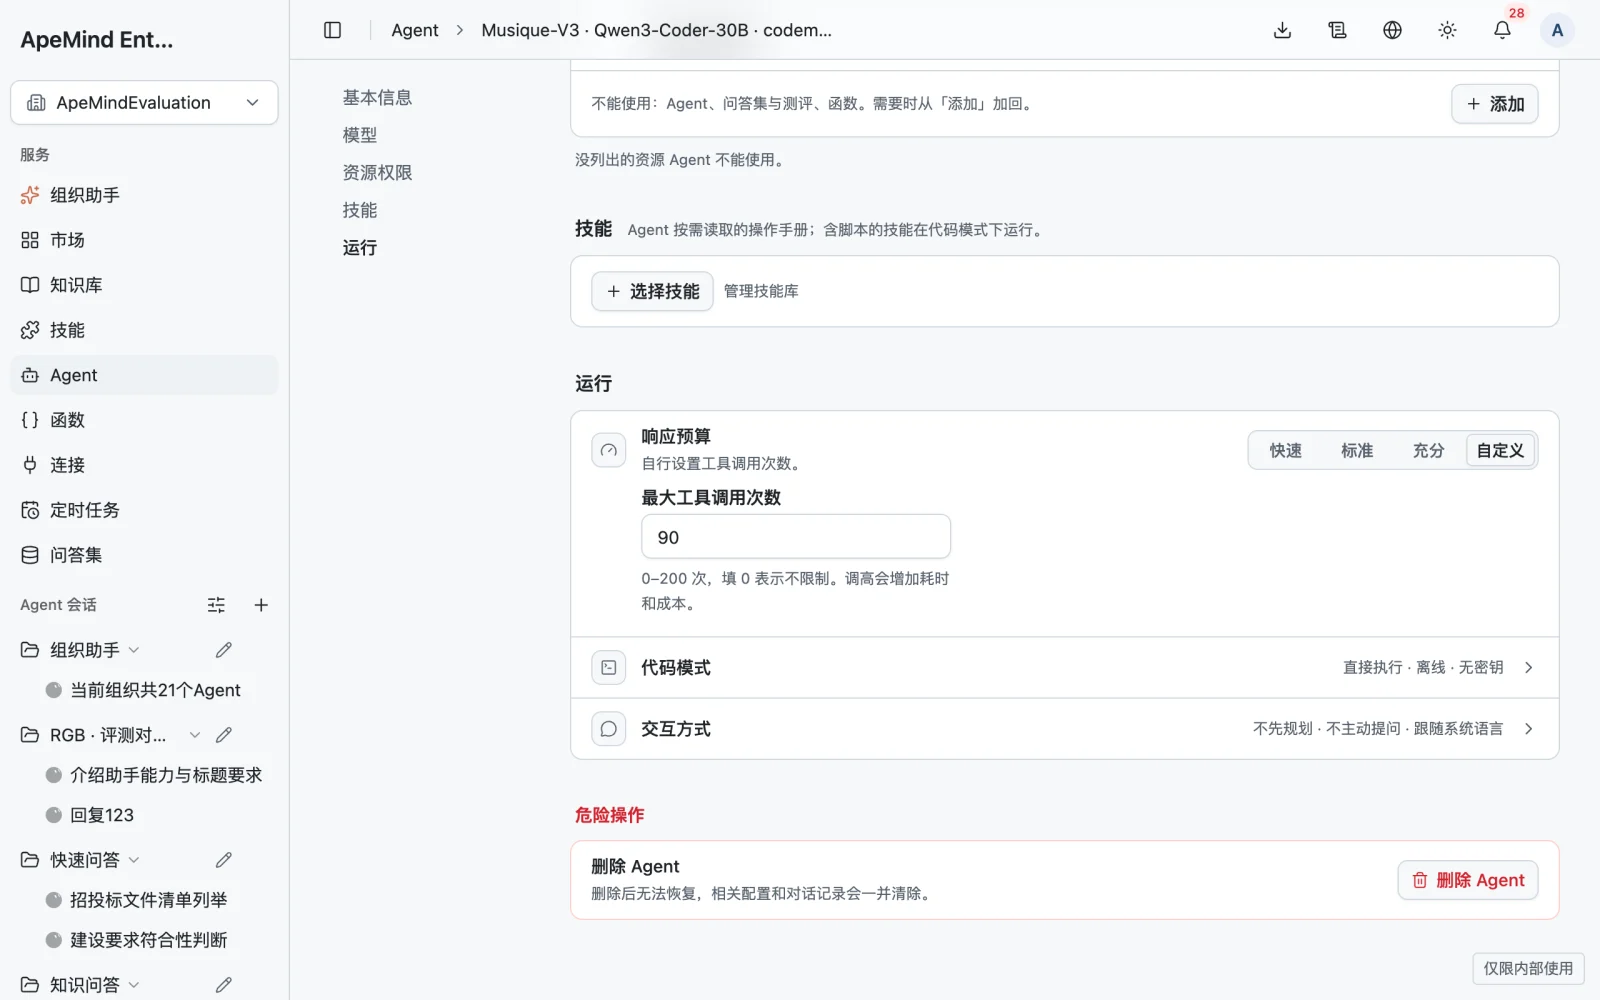
- 开启代码模式(Code Mode):在「运行」分组中打开代码模式,执行方式选「直接执行」,公网门禁保持关闭(纯离线沙箱安全分析内部研报);响应预算选充分(最多 150 次),给跨多份长年报的深度核对留足步数。
- 装载内置专业技能:在「技能」分组勾选平台内置的表格文件、图解表达与报告文档技能,使 Agent 能直接输出带公式的 Excel 对标表、高清晰度对比图与结构化分析报告。
- 设定财务分析人设与口径纪律:
- “提取任何财务指标时,必须先核对报表表头标注的金额单位(元/千元/万元/亿元)及是否经追溯调整,再在 Python 代码中统一换算为「亿元」后进行比率与同比计算,严禁口算。”
- “输出对比表时,每个原始数据必须标注来源报告与章节/附注编号;如不同公司会计口径存在差异(如研发费用资本化口径),必须在结论下方单列口径差异说明。”
第三步:发起多表对比分析并做句级溯源审计
在对话页直接下达复合分析任务,例如:“对比库内目标公司 2023–2025 年营业收入、归母净利润、研发费用率及经营活动现金流净额变化,统一换算为亿元,用 Python 计算同比增速并生成对比折线图与可下载的 Excel 汇总表。”
- Agent 会先在对话中呈现执行计划,分批检索各年份合并利润表与现金流量表片段并核对追溯重述附注;
- 随后在隔离沙箱中运行 Python 脚本完成单位统一、指标运算、勾稽校验(如总营收 = 各业务分部之和)以及图表生成;
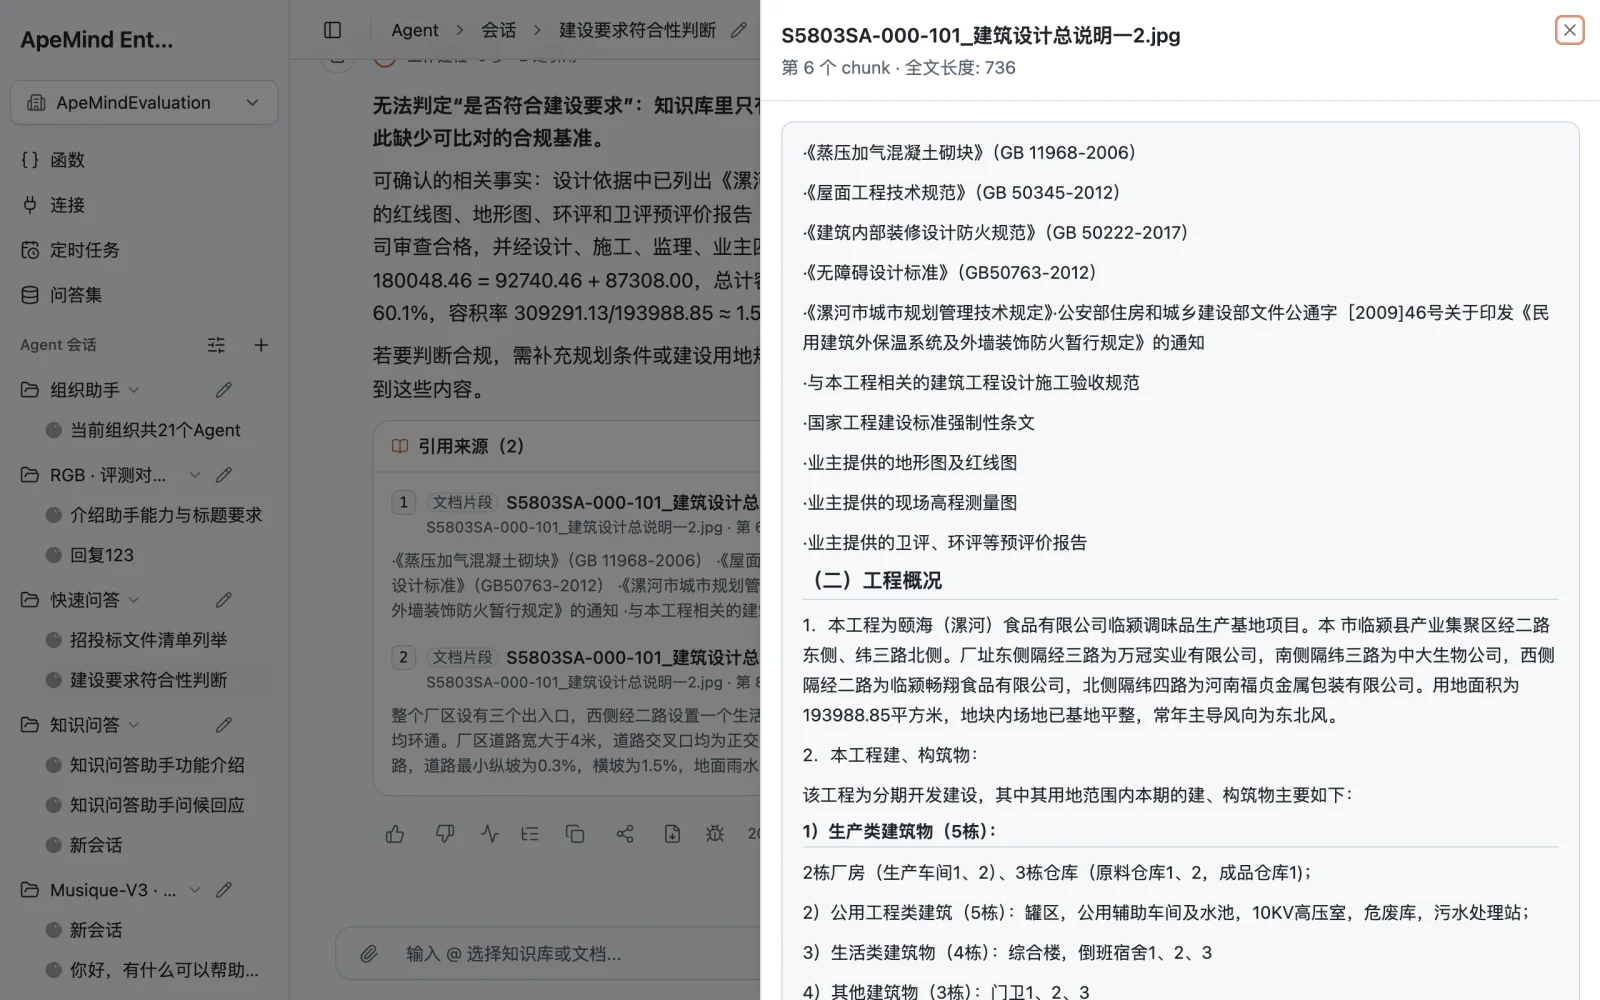
- 审稿人点击回答中任意数字旁的引用角标,右侧立即展开原文溯源抽屉,3 秒内直接对照原报告披露段落核验无误。
进阶提效:把固定财务模板固化为组织技能
如果投研团队每周都要按固定框架撰写“季报点评”或“行业对标简报”,可以把团队的估值指标公式、口径检查清单和排版规范写成一份自定义组织技能挂载给 Agent。同时,对于每次都要重复跑的标准化财务计算,可进一步封装成只读函数,确保全团队产出口径高度一致。